1、什么是CUDA?
CUDA是NVIDIA建立在GPU上的一个通用并行计算平台和编程模型,基于CUDA编程可以利用GPUs的并行计算引擎来更加高效地解决比较复杂的计算难题。
GPU包括更多的运算核心,其特别适合数据并行的计算密集型任务;
CPU的运算核心较少,但是其可以实现复杂的逻辑运算。2、编程基础
用host指代CPU及其内存,而用device指代GPU及其内存,CUDA程序中既包含host程序,又包含device程序,它们分别在CPU和GPU上运行。同时,host与device之间可以进行通信,这样它们之间可以进行数据拷贝。典型的CUDA程序的执行流程如下:
-
分配host内存,并进行数据初始化;
-
分配device内存,并从host将数据拷贝到device上;
-
调用CUDA的核函数在device上完成指定的运算;
-
将device上的运算结果拷贝到host上;
-
释放device和host上分配的内存。
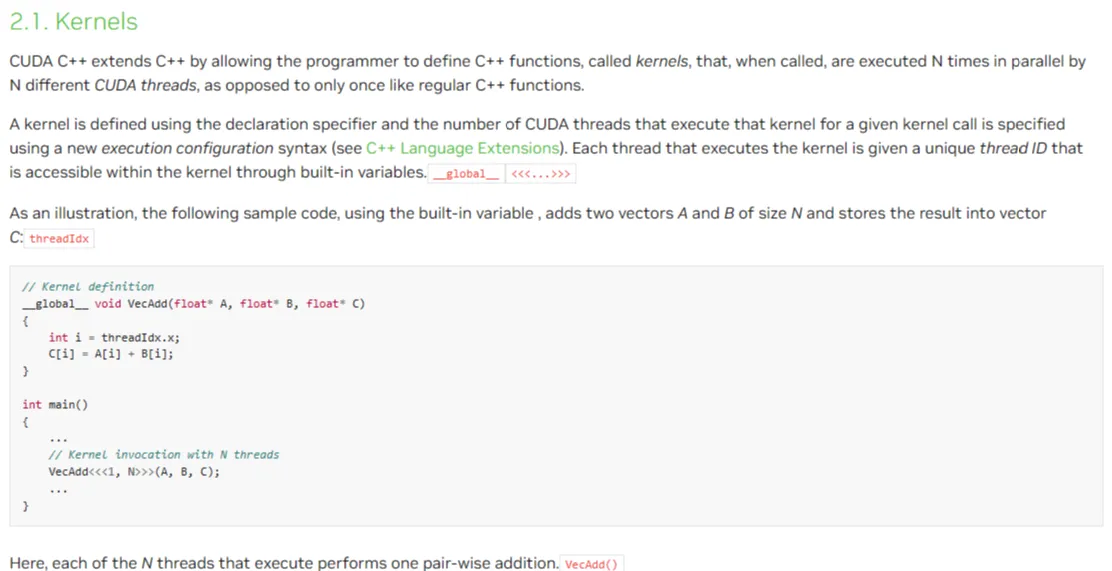
上面流程中最重要的一个过程是调用CUDA的核函数来执行并行计算,kernel是CUDA中一个重要的概念,kernel是在device上线程中并行执行的函数,核函数用
__global__符号声明(告诉编译器,在GPU上运行),在调用时需要用<<<grid, block>>>来指定kernel要执行的线程数量,在CUDA中,每一个线程都要执行核函数,并且每个线程会分配一个唯一的线程号thread ID,这个ID值可以通过核函数的内置变量threadIdx来获得。
由于GPU实际上是异构模型,所以需要区分host和device上的代码,在CUDA中是通过函数类型限定词开区别host和device上的函数,主要的三个函数类型限定词如下-
__global__:在device上执行,从host中调用(一些特定的GPU也可以从device上调用),返回类型必须是void,不支持可变参数参数,不能成为类成员函数。注意用__global__定义的kernel是异步的,这意味着host不会等待kernel执行完就执行下一步。 -
__device__:在device上执行,单仅可以从device中调用,不可以和__global__同时用。 -
__host__:在host上执行,仅可以从host上调用,一般省略不写,不可以和__global__同时用,但可和__device__,此时函数会在device和host都编译。必须要对kernel的线程层次结构有一个清晰的认识。首先GPU上很多并行化的轻量级线程。kernel在device上执行时实际上是启动很多线程,一个kernel所启动的所有线程称为一个网格(grid),同一个网格上的线程共享相同的全局内存空间,grid是线程结构的第一层次,而网格又可以分为很多线程块(block),一个线程块里面包含很多线程,这是第二个层次。线程两层组织结构如下图所示,这是一个gird和block均为2-dim的线程组织。
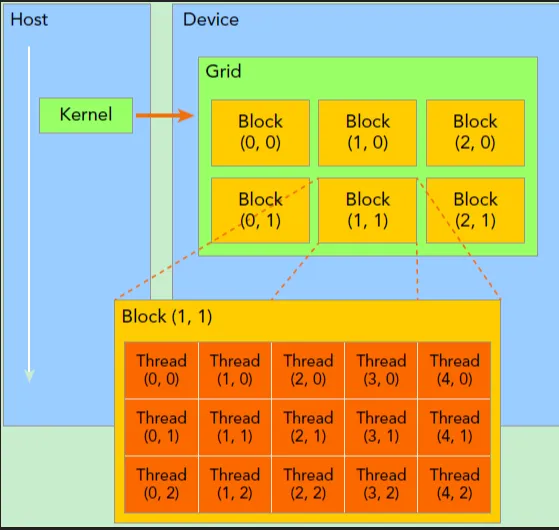
dim3 grid(3, 2);dim3 block(5, 3);kernel_fun<<< grid, block >>>(prams...);一个线程需要两个内置的坐标变量(blockIdx,threadIdx)来唯一标识,它们都是`dim3`类型变量,其中blockIdx指明线程所在grid中的位置,而threaIdx指明线程所在block中的位置,如图中的Thread (1,1)满足:threadIdx.x = 1threadIdx.y = 1blockIdx.x = 1blockIdx.y = 1一个线程块上的线程是放在同一个流式多处理器(SM)上的,但是单个SM的资源有限,这导致线程块中的线程数是有限制的,现代GPUs的线程块可支持的线程数可达1024个。有时候,我们要知道一个线程在blcok中的全局ID,此时就必须还要知道block的组织结构,这是通过线程的内置变量blockDim来获得。它获取线程块各个维度的大小。对于一个2-dim的block $(D_{x},D_{y})$,线程$(x,y)$ 的ID值为$(x+y*D_{x})$ ,如果是3-dim的block$ (D_{x},D_{y},D_{z})$ ,线程 $(x,y,z)$ 的ID值为$(x+y*D_{x}+z*D_{x}*D_{y})$ 。另外线程还有内置变量gridDim,用于获得网格块各个维度的大小。
kernel的这种线程组织结构天然适合vector,matrix等运算,如我们将利用上图dim结构实现两个矩阵的加法,每个线程负责处理每个位置的两个元素相加,代码如下所示。线程块大小为(16, 16),然后将N*N大小的矩阵均分为不同的线程块来执行加法运算.// Kernel定义__global__ void MatAdd(float A[N][N], float B[N][N], float C[N][N]){ int i = blockIdx.x * blockDim.x + threadIdx.x; int j = blockIdx.y * blockDim.y + threadIdx.y; if (i < N && j < N) C[i][j] = A[i][j] + B[i][j];}int main(){ ... // Kernel 线程配置 dim3 threadsPerBlock(16, 16); dim3 numBlocks(N / threadsPerBlock.x, N / threadsPerBlock.y); // kernel调用 MatAdd<<<numBlocks, threadsPerBlock>>>(A, B, C); ...}由于SM的基本执行单元是包含32个线程的线程束,所以block大小一般要设置为32的倍数.
配置检查:(在进行CUDA编程前,可以先检查一下自己的GPU的硬件配置)
int dev = 0; cudaDeviceProp devProp; CHECK(cudaGetDeviceProperties(&devProp, dev)); std::cout << "使用GPU device " << dev << ": " << devProp.name << std::endl; std::cout << "SM的数量:" << devProp.multiProcessorCount << std::endl; std::cout << "每个线程块的共享内存大小:" << devProp.sharedMemPerBlock / 1024.0 << " KB" << std::endl; std::cout << "每个线程块的最大线程数:" << devProp.maxThreadsPerBlock << std::endl; std::cout << "每个EM的最大线程数:" << devProp.maxThreadsPerMultiProcessor << std::endl; std::cout << "每个SM的最大线程束数:" << devProp.maxThreadsPerMultiProcessor / 32 << std::endl;
// 输出如下 使用GPU device 0: GeForce GT 730 SM的数量:2 每个线程块的共享内存大小:48 KB 每个线程块的最大线程数:1024 每个EM的最大线程数:2048 每个EM的最大线程束数:643、一些示例
CUDA编程中内存管理API。首先是在device上分配内存的**cudaMalloc函数**,这个函数和C语言中的malloc类似,但是在device上申请一定字节大小的显存。其中devPtr是指向所分配内存的指针。同时要释放分配的内存使用**cudaFree函数**,这和C语言中的free函数对应。cudaError_t cudaMalloc(void** devPtr, size_t size);重要的函数是负责host和device之间数据通信的**cudaMemcpy函数**:cudaError_t cudaMemcpy(void* dst, const void* src, size_t count, cudaMemcpyKind kind)其中src指向数据源,而dst是目标区域,count是复制的字节数,其中kind控制复制的方向:cudaMemcpyHostToHost, cudaMemcpyHostToDevice, cudaMemcpyDeviceToHost及cudaMemcpyDeviceToDevice,如cudaMemcpyHostToDevice将host上数据拷贝到device上。-
向量加法
定义kernel:
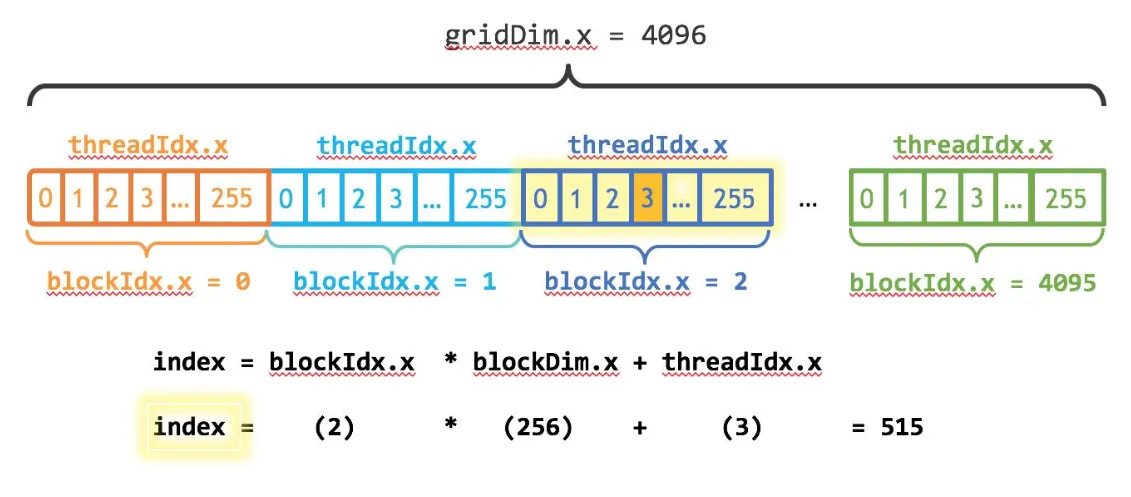
// 两个向量加法kernel,grid和block均为一维__global__ void add(float* x, float * y, float* z, int n){ // 获取全局索引 int index = threadIdx.x + blockIdx.x * blockDim.x; // 步长 int stride = blockDim.x * gridDim.x; for (int i = index; i < n; i += stride) { z[i] = x[i] + y[i]; }}stride是整个grid的线程数,有时候向量的元素数很多,这时候可以将在每个线程实现多个元素(元素总数/线程总数)的加法,相当于使用了多个grid来处理,这是一种[grid-stride loop](https://link.zhihu.com/?target=https%3A//devblogs.nvidia.com/cuda-pro-tip-write-flexible-kernels-grid-stride-loops/)方式,不过下面的例子一个线程只处理一个元素,所以kernel里面的循环是不执行的。下面我们具体实现向量加法:int main(){ int N = 1 << 20; // 二进制编码左移20 int nBytes = N * sizeof(float); // 申请host内存 float *x, *y, *z; x = (float*)malloc(nBytes); y = (float*)malloc(nBytes); z = (float*)malloc(nBytes);
// 初始化数据 for (int i = 0; i < N; ++i) { x[i] = 10.0; y[i] = 20.0; }
// 申请device内存 float *d_x, *d_y, *d_z; cudaMalloc((void**)&d_x, nBytes); cudaMalloc((void**)&d_y, nBytes); cudaMalloc((void**)&d_z, nBytes);
// 将host数据拷贝到device cudaMemcpy((void*)d_x, (void*)x, nBytes, cudaMemcpyHostToDevice); cudaMemcpy((void*)d_y, (void*)y, nBytes, cudaMemcpyHostToDevice); // 定义kernel的执行配置 dim3 blockSize(256); dim3 gridSize((N + blockSize.x - 1) / blockSize.x); // 执行kernel add << < gridSize, blockSize >> >(d_x, d_y, d_z, N);
// 将device得到的结果拷贝到host cudaMemcpy((void*)z, (void*)d_z, nBytes, cudaMemcpyDeviceToHost);
// 检查执行结果 float maxError = 0.0; for (int i = 0; i < N; i++) maxError = fmax(maxError, fabs(z[i] - 30.0)); std::cout << "最大误差: " << maxError << std::endl;
// 释放device内存 cudaFree(d_x); cudaFree(d_y); cudaFree(d_z); // 释放host内存 free(x); free(y); free(z);
return 0;}这里我们的向量大小为1<<20,而block大小为256,那么grid大小是4096,kernel的线程层级结构如下图所示: